이 사이트의 쿼리도 AI를 만들어 온 기록입니다. 처음에는 예전에 만들어 둔 hard AI를 이겨 보고 싶었을 뿐인데,
하다 보니 목표가 GitHub에 공개된 강한 엔진들로 옮겨 갔습니다.
1편
알고리즘 AI를 이기기까지
2026년 9월 중순 ~ 9월 26일
출발점: 'hard' AI
처음부터 거창한 목표를 세운 것은 아닙니다. 예전에 만든 웹 쿼리도 게임에 'hard' 난이도 AI가 있었는데, 이걸 먼저 이겨 보자는 생각이었습니다.
hard는 사람이 정한 평가 기준(내 남은 거리와 상대 남은 거리의 차 등)으로 몇 수 앞까지 읽는 전통적인 탐색 알고리즘입니다.
이것을 신경망 AI가 스스로 배워서 이기게 하는 것이 첫 과제였습니다.
첫 시도: 강화학습만으로는 한 판도 이기지 못했다
강화학습(PPO)으로 v1부터 v18까지 열여덟 개 버전을 만들어 봤습니다.
보상을 바꾸고, 쉬운 상대부터 한 칸씩 올라가는 사다리도 만들고, hard의 수를 흉내 낸 모델에서 출발해 보기도 했습니다.
그래도 hard 상대로는 40판에 0~2승뿐이었습니다.
로그와 대국을 다시 뜯어보니 막힌 곳이 세 군데 있었습니다.
학습을 돕겠다고 넣은 "강제 수"가 AI의 수를 50~75%나 덮어써서, AI가 자기 수로 배운 것이 거의 없었습니다.
둘 수 없는 수를 걸러 주는 장치가 없어서 AI가 엉뚱한 수를 고르는 데 학습을 낭비했습니다.
판마다 실제로 학습에 반영되는 횟수가 너무 적었습니다.
열여덟 버전을 거듭 고쳐도 hard 상대로 40판 중 0~2승에 그쳤습니다. 이때는 정말 주저앉고 싶었습니다.
두 번째 시도: 후보 수 정책망
방법을 바꿨습니다. 136가지 수 전부를 고르게 하는 대신, 말 이동 전부와 "상대를 가장 많이 늦추는 벽 8개"만 후보로 주고,
작은 신경망이 후보마다 점수를 매기게 했습니다. 둘 수 없는 수는 아예 후보에 들어가지 않으니 불법 수가 구조적으로 사라집니다.
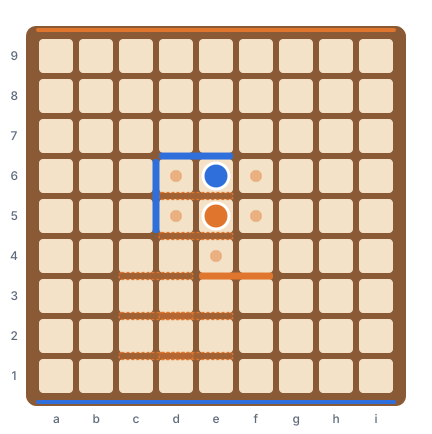
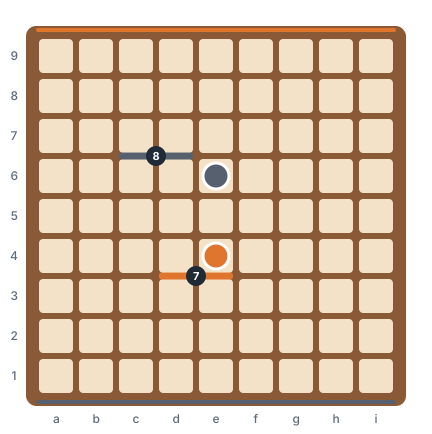
후보 수 정책망이 보는 판(실제 대국 10수째, 주황이 AI 차례). 연한 점은 말이 갈 수 있는 칸, 점선 벽은 상대 길을 가장 많이 늘리는 벽 8개입니다. AI는 이 중에서만 고릅니다.
학습은 두 단계였습니다. 먼저 3수 앞을 읽는 탐색기의 수를 따라 배워 출발점을 만들고, 그다음 hard와 직접 두며 승패만으로 강화학습을 했습니다.
처음부터 강화학습만 하면 2,528판을 두는 동안 한 판도 이기지 못했으니, 출발점을 잡는 단계가 꼭 필요했습니다.
학습 상대
hard 3수 읽기
hard 5수 읽기
3수 읽기만
98.3%
58.0%
5수 읽기만
70.3%
84.0%
3수·5수 번갈아
97.7%
91.5%
5수 읽기 상대로만 학습시켰더니 3수 읽기 상대를 이기던 실력이 70%로 내려앉았습니다. 한 상대에게만 맞추면 다른 상대를 금방 놓친다는 걸 이때 처음 봤는데,
이 문제는 뒤에서도 몇 번이나 다시 나옵니다.
공개 엔진에게 당한 전패
hard를 넘은 뒤, GitHub에 공개된 쿼리도 AI들과 겨뤄 봤습니다. 모든 판은 우리 규칙 엔진이 심판을 봤습니다.
학교 수업 대회 우승작이나 몇몇 탐색 엔진은 확실히 이겼지만, 신경망과 수읽기를 결합한 두 엔진에게는 완패했습니다.
새 AI의 뼈대는 신경망 하나가 두 가지를 동시에 답하는 구조입니다. "이 국면에서 어떤 수가 좋아 보이나"(정책)와
"이 국면은 누가 이기고 있나"(가치)입니다. 실제로 둘 때는 이 신경망을 길잡이로 삼아 수백 갈래를 미리 읽어 보고(수읽기), 가장 많이 검토한 수를 둡니다.
학습 재료는 AI가 자기 자신과 둔 대국입니다. 한 번 학습할 때마다 1,000판 정도를 새로 두고,
그 판에서 수읽기가 내린 결론과 실제 승패를 신경망에 가르칩니다. 새로 학습한 모델이 기존 최고 모델을 55% 이상 이기면 교체합니다.
처음에는 클라우드 GPU를 빌려 썼고, 얼마 뒤부터는 집에 있는 작업용 PC(그래픽카드 한 장)로 옮겨 한 번에 20~30분씩 돌렸습니다.
사람에게 갇힌 AI
이 무렵 웹 게임을 열어 사람과 두게 했는데, 개발자가 이 AI를 어렵지 않게 이겼습니다.
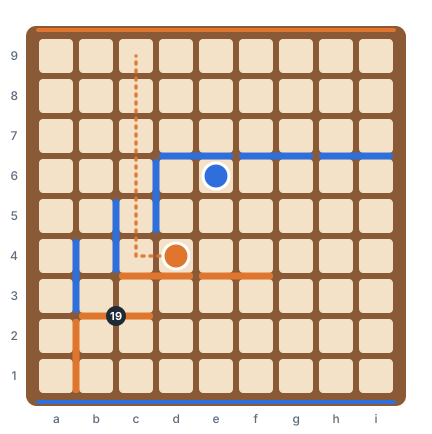
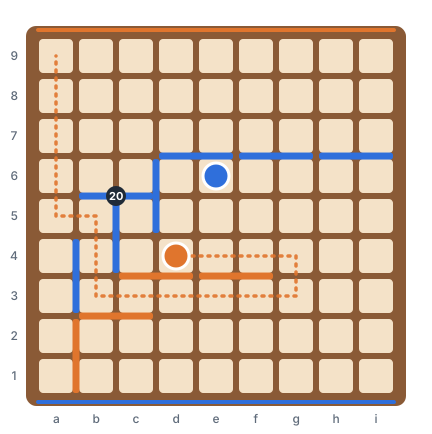
10~18수 동안 AI 말 주변에 벽을 하나씩 세워 우리(감옥)를 만들고, 20수째에 입구를 닫자 AI의 남은 거리가 6칸에서 16칸으로 늘어났습니다.
실제 대국 20수째를 그대로 옮긴 장면. 파란 띠 벽이 사람이 세운 벽입니다. 주황 캐릭터(AI)가 벽 안에 갇혔습니다.
19수째. AI(주황)의 최단거리는 6칸입니다. 점선이 그 경로입니다.20수째. 사람이 벽 하나(20)로 입구를 닫자 AI의 최단거리가 6칸에서 16칸으로 늘었습니다.
기보 그림 보는 법:AI사람상대 엔진 · 판 위아래의 색 띠는 각 말의 목표 줄을, 벽에 적힌 숫자는 그 벽을 몇 번째 수에 뒀는지를 나타냅니다.
더 답답했던 건 AI의 형세 판단이었습니다. 감옥이 지어지는 내내 AI는 자기가 "거의 확실히 이기고 있다"고 보고 있었습니다.
자기 자신과 두는 대국에서는 여러 수에 걸쳐 조용히 감옥을 짓는 전략이 거의 나오지 않으니, 이런 위험을 배울 기회가 없었던 것입니다.
학습을 더 진행한 모델은 같은 위험을 2~4수 일찍 알아챘고, 이후 사람이 감옥을 지으려 한 판에서는 맞벽을 세워 빠져나가기도 했습니다.
한 칸 차로 진 판들
Sigma에게 진 판을 하나하나 다시 보니 17패 중 10패가 한 칸 차였습니다. 막판에 서로 벽을 주고받으며 달리는 경주에서 계산이 모자랐던 겁니다.
모델은 그대로 두고 한 수에 읽는 양만 200번에서 800번으로 늘려 봤습니다.
같은 모델
한 수에 200번 읽기
800번 읽기
Sigma 상대 (20판)
3승
17승
그래서 이 웹 게임의 AI도 평소에는 빠르게 200번 읽고, 두 말이 모두 결승선에 가까워지면 800번 읽습니다.
신경망 입력도 보강했습니다. 판 모양 외에 "지금 내가 벽 하나를 두면 상대 길이 최대 몇 칸 늘어나나", "상대 벽 하나가 내 길을 최대 몇 칸 늘리나"를
지도로 만들어 함께 보여 주었습니다.
상대의 수는 배우지 않는다
자기 자신과만 두면 아무래도 시야가 좁아집니다. 그래서 Sigma와 실제로 둔 대국도 학습에 섞었습니다.
다만 Sigma가 둔 수를 정답으로 넣지는 않았습니다. 그 판에서 우리 AI가 수읽기로 내린 결론과 판의 승패만 배우게 했습니다.
상대를 흉내 내지 말고 그 상대를 이기는 법을 배우라는 뜻이고, 이 원칙은 지금까지 그대로입니다.
V1 '큐리도(Kyu-Ridor)'
70번째 학습 반복에서 나온 모델을 첫 정식 버전으로 정했습니다. 자기 대국 약 7만 5천 판, 작업용 PC로 약 23시간 학습한 결과입니다.
상대
V1 성적
SigmaQuoridor
60전 60승
sugi (1,000 노드)
20전 0승
V1 큐리도. Sigma를 선공·후공 모두 이긴 첫 모델입니다.
Sigma는 선공·후공 모두 전승으로 넘었습니다. 하지만 sugi에게는 여전히 한 판도 이기지 못했습니다.
V1을 정리하다가 이상한 걸 하나 발견했습니다. 학습 데이터에 수순이 완전히 같은 판이 많이 섞여 있었습니다.
자기 대국의 13~30%가 중복이었고, 한 판이 373번 들어간 경우도 있었습니다. 초반 몇 수를 AI가 너무 확신해서 무작위성을 넣어도 판이 갈라지지 않은 것입니다.
같은 판을 여러 번 배우면 그 수순을 더 확신하게 되고, 그래서 같은 판이 또 나오는 악순환이 생깁니다. 이 문제는 3편으로 이어집니다.
sugi를 이기려고 sugi와 둔 대국을 학습에 많이 섞었습니다. 그런데 sugi 승수는 그대로인데 Sigma 성적이 먼저 무너졌습니다. 60전 60승이던 것이 한때 20전 5승까지 떨어졌습니다.
로그를 따라가 보니 몇 가지가 겹쳐 있었습니다.
sugi와 둔 판의 86%가 패배였고, 같은 패배 판이 최대 122번 반복해 들어갔습니다. 배울 거리가 "진다"는 신호뿐이었습니다.
AI의 형세 판단이 "이 국면이 나쁘다"가 아니라 "sugi가 이어서 두면 진다"를 배웠습니다. 같은 모양이 자기 대국에서는 이기고 sugi 대국에서는 지니 판단이 꼬였습니다.
이미 진 국면에서는 어떤 수를 둬도 결과가 같아서, 수읽기의 결론이 사실상 무작위입니다. 그런 국면이 학습 목표의 37%나 됐습니다.
sugi 공부에 매달리다 Sigma 상대법을 잊어버린 시기.
데이터 정제와 핸디캡 사다리 → V2 'QuoRim'
그래서 무엇을 배우게 할지부터 손봤습니다. 같은 판, 같은 국면, 이미 승부가 난 국면의 수, 한 판 안에서 왔다갔다 되풀이된 국면을 학습에서 뺐습니다.
그리고 sugi의 수읽기 양을 1,000에서 300으로 낮춰, 우리가 40% 정도 이길 수 있는 상대로 만들었습니다. 바둑의 접바둑처럼, 이길 수 있는 상대와 두면서 이기는 판을 배우게 한 것입니다.
신경망 구조는 그대로 두고 학습 자료만 바꿨습니다. 그렇게 세 번 돌린 끝에 처음으로 sugi를 이겼습니다.
측정
V1
V2 QuoRim
sugi 1,000 노드 (20판)
0승
5승
V1과 직접 대국 (400판)
—
71.8%
sugi와의 차이는 우리가 선공일 때 났다
sugi와 같은 양을 읽게 하고 비교해 보니 흥미로운 사실이 나왔습니다. 우리가 후공일 때는 sugi와 대등했고, 차이는 거의 전부 우리가 선공인 판에서 났습니다.
더 파고들자 선공 패배의 대부분이 초반 한 수순에서 나왔습니다. 우리가 넷째 수에 특정 자리에 벽을 두고 sugi가 그에 맞받아치는 수순인데, 그 뒤 승률이 9%였습니다.
그런데도 우리 AI는 그 국면을 자기가 유리하다고 보고 있었습니다.
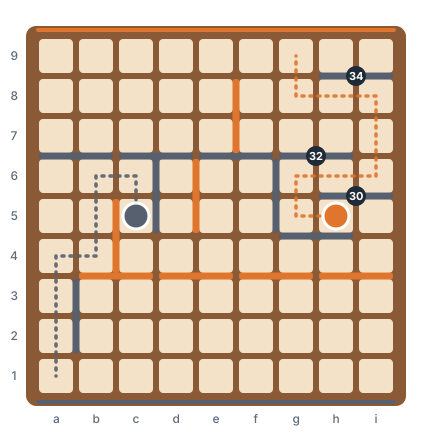
V2(주황, 선공)와 sugi(회색)의 실제 대국 8수째. 7은 우리 넷째 수 벽, 8은 sugi의 맞벽입니다. 이 수순으로 간 판 대부분을 졌습니다.같은 판 34수째. sugi가 30·32·34수에 마지막 벽 세 개를 몰아 써서 우리 길을 9칸으로 늘렸습니다(sugi는 8칸). 우리에게는 벽이 3개 남았지만 sugi의 길을 한 칸이라도 늘릴 자리가 남아 있지 않았고, 결국 벽을 쥔 채 한 칸 차로 졌습니다.
“전하, 신에게는 아직 세 개의 벽이 남아 있사옵니다.”영화 〈명량〉 패러디
반대로 sugi의 막판 완전 계산은 승부를 가르지 않았습니다. 진 판을 모두 따라가 보니 sugi가 막판 계산에 들어간 시점에 우리가 앞서 있던 판은 한 판도 없었습니다.
승부는 벽이 남아 있는 중반에 이미 갈렸습니다.
한쪽만 연습하면 다른 쪽을 잊는다
그 약점 수순만 집중해서 연습시키자 sugi 상대 선공 승률이 60%까지 올랐습니다. 대신 이번에는 후공이 무너졌고, Sigma 상대도 20전 9승으로 내려갔습니다.
그래서 sugi와 선공만 두는 대국, 후공만 두는 대국을 따로 만들어 6:4로 섞고, Sigma 대국도 함께 넣어 학습했습니다.
V3 'QuoRim-3'
측정
V1
V2
V3
직전 모델과 직접 대국 (400판)
—
71.8%
88.2%
SigmaQuoridor (20판)
60/60
16/20
19/20
sugi 1,000 노드
0/20
14/60
11/40
V3는 V2를 88.2%로 이기고 Sigma 성적도 거의 회복했습니다. sugi 상대로는 28%로, 아직 갈 길이 멉니다.
지금 이 사이트에서 여러분과 두는 AI가 바로 V3입니다.
지금 이 사이트의 AI, V3 QuoRim-3.
V3를 만든 뒤에는 엔진끼리 둬서는 안 보이는 약점이 있을 것 같아, 사람들에게 직접 도전을 받아 보기로 했습니다.
그래서 AI에게 도전하는 페이지를 따로 열었는데, 생각보다 훨씬 강한 분이 나타났습니다. 그 이야기는 4편에서 하겠습니다.
10월 24일, V3를 상대로 하는 도전 페이지를 열었습니다. 닉네임을 정하고 기록 저장에 동의한 뒤 선공·후공을 고르면 바로 대국이 시작됩니다.
AI는 한 수에 800번을 읽는 V3이고, 사람이 이기면 서버만 아는 열쇠로 만든 인증 코드가 화면에 뜹니다.
첫 주에는 바깥에서 들어온 도전이 한 판도 없었습니다. 11월 1일에 커뮤니티 몇 곳에 글을 다시 올리고 나서야 사람들이 오기 시작했습니다.
그런데 처음 기록된 "사람 승리"는 사람이 이긴 판이 아니었습니다. 두 판을 동시에 열어 놓고 한쪽 AI의 수를 다른 쪽에 그대로 옮겨 두는 방식이었는데,
결국 AI끼리 둔 셈이라 두 판의 수순이 43수까지 똑같았습니다.
35연승, 그리고 예파
11월 6일 오전, 커뮤니티에 글을 올리고 한 시간쯤 지나 '예파'라는 분이 들어왔습니다. 예파 님이 들어오기 전까지 정상 대국 35판은 모두 AI가 이겼습니다.
예파 님은 오후 3시 무렵까지 쉬지 않고 도전했고, 그날만 두 번을 이겼습니다.
“뭐가 나왔다고 거기서... 겁나 험한 게.”영화 〈파묘〉
첫 승은 51수, 3분 43초 만이었습니다. AI가 오른쪽으로 돌아 내려가던 통로를 벽 4개로 막아 AI의 남은 거리를 5칸에서 12칸으로 늘렸고,
예파 님은 벽 10개를 모두 썼습니다.
이 판을 뜯어보다가 더 큰 구멍을 발견했습니다. AI가 같은 국면에서는 늘 같은 수만 두고 있었습니다. 이 51수를 그대로 따라 두면 누구라도 이길 수 있다는 뜻입니다.
그래서 그날 급히, 초반 30수 동안은 비슷하게 좋은 수 가운데 하나를 무작위로 고르게 고쳤습니다.
27수째, 벽 하나
고친 뒤에도 예파 님은 다시 들어왔고, 두 번째 승리는 첫 6수만 같았을 뿐, 따라 두기가 아닌 새 판이었습니다. 43수, 4분 29초.
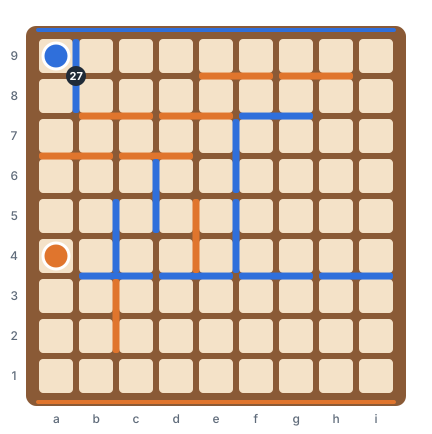
AI는 18수째 형세를 +0.96(1에 가까울수록 이긴다는 확신)으로 보고 있었고, 26수째에도 +0.95였습니다. 25수째 세로벽 때문에 AI의 남은 거리가 이미 6칸에서 10칸으로 늘어나 있었는데도 말입니다.
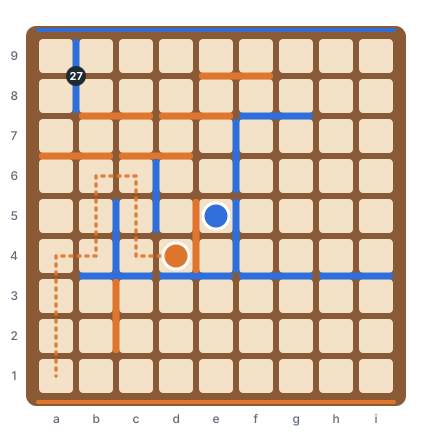
27수째 예파 님이 a열 맨 끝에 세로벽 하나를 세우자, 그제야 AI의 판단이 −0.89로 뒤집혔습니다. AI에게는 그 벽이 그냥 벽 하나로 보였던 모양입니다.
AI가 갇힌 자리에서 10칸을 돌아 나오는 사이, 예파 님은 왼쪽 끝으로 쭉 걸어가 결승선에 닿았습니다.
27수째. 예파 님(파랑)이 a열 끝에 세로벽(27)을 세운 직후입니다. 점선은 AI(주황)가 빠져나가야 하는 10칸 길입니다.43수째, 최종 국면. 예파 님은 벽 10개를 다 썼고, AI 말은 아직 왼쪽 아래에서 빠져나오는 중입니다.
다섯 번째 승리까지
11월 7일과 8일에도 예파 님은 세 번을 더 이겼습니다. 그중 한 판에서 AI는 20수째 왼쪽 가장자리 쪽으로 말을 옮겼습니다. 이때만 해도 남은 거리는 AI 3칸, 예파 님 5칸으로 AI가 앞서 있었습니다.
예파 님은 그 뒤 벽 몇 개로 가장자리를 조금씩 막았고, 33수째 마지막 벽 하나로 AI의 길을 2칸에서 8칸으로 늘렸습니다. 나중에 그 20수째 국면을 4,000번씩 읽혀 보니 V3도 실제로 둔 수와 다른 수 사이에서 거의 반반으로 갈렸습니다.
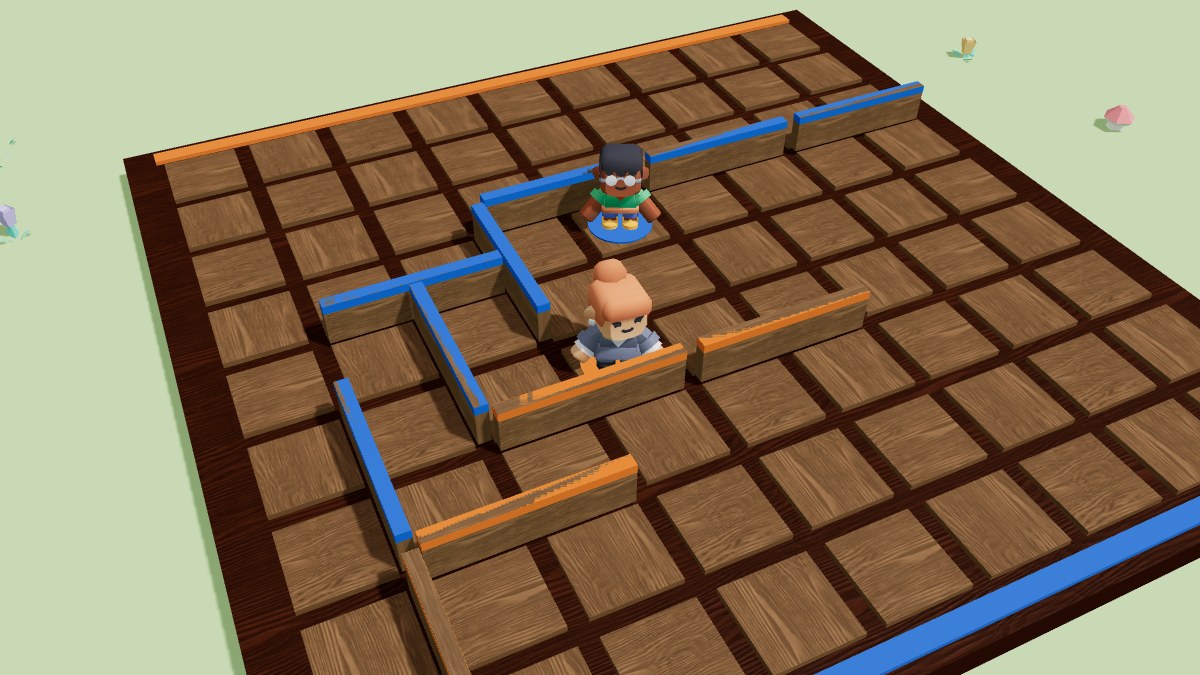
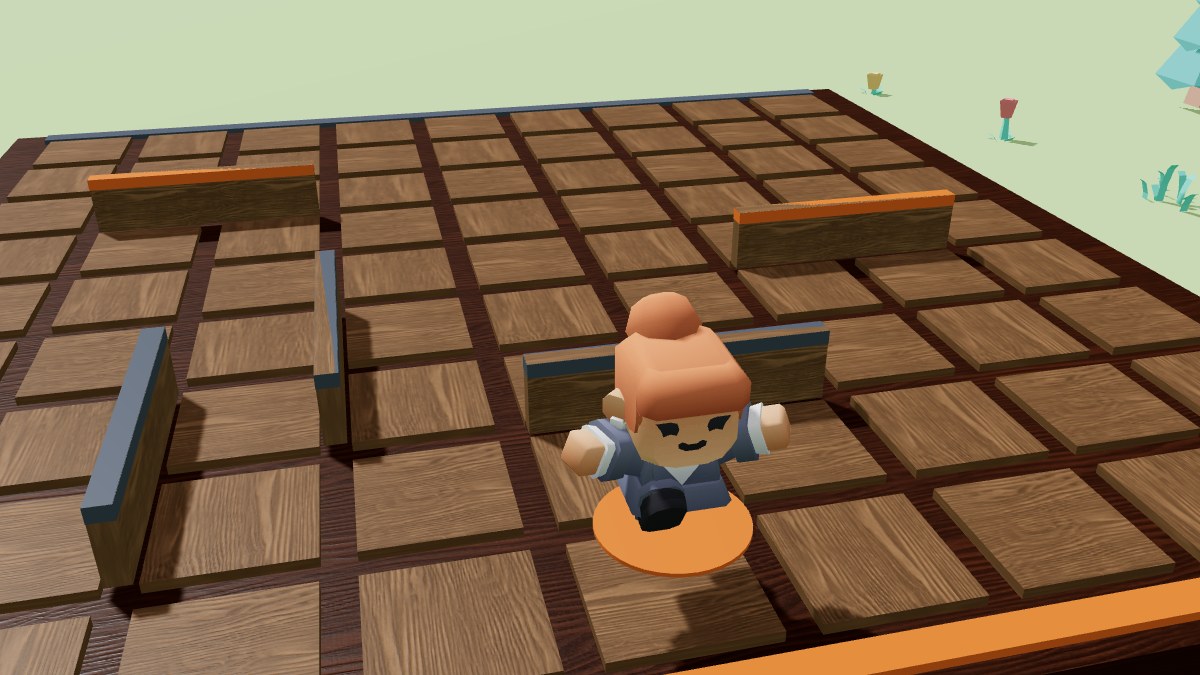
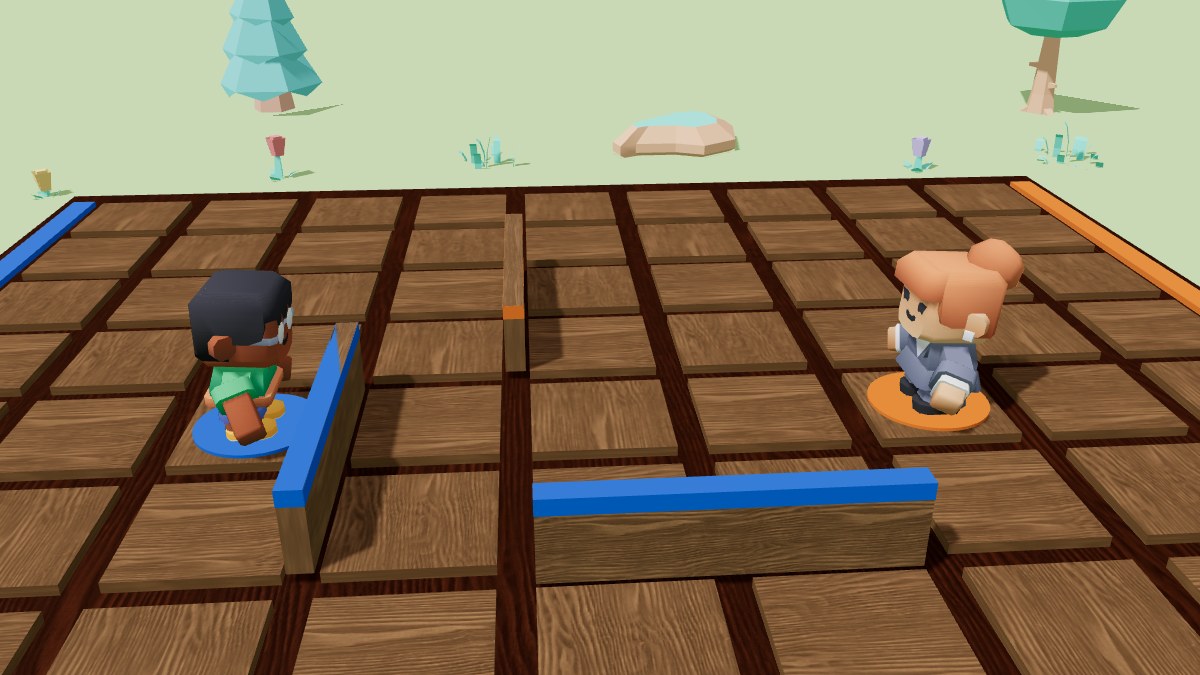
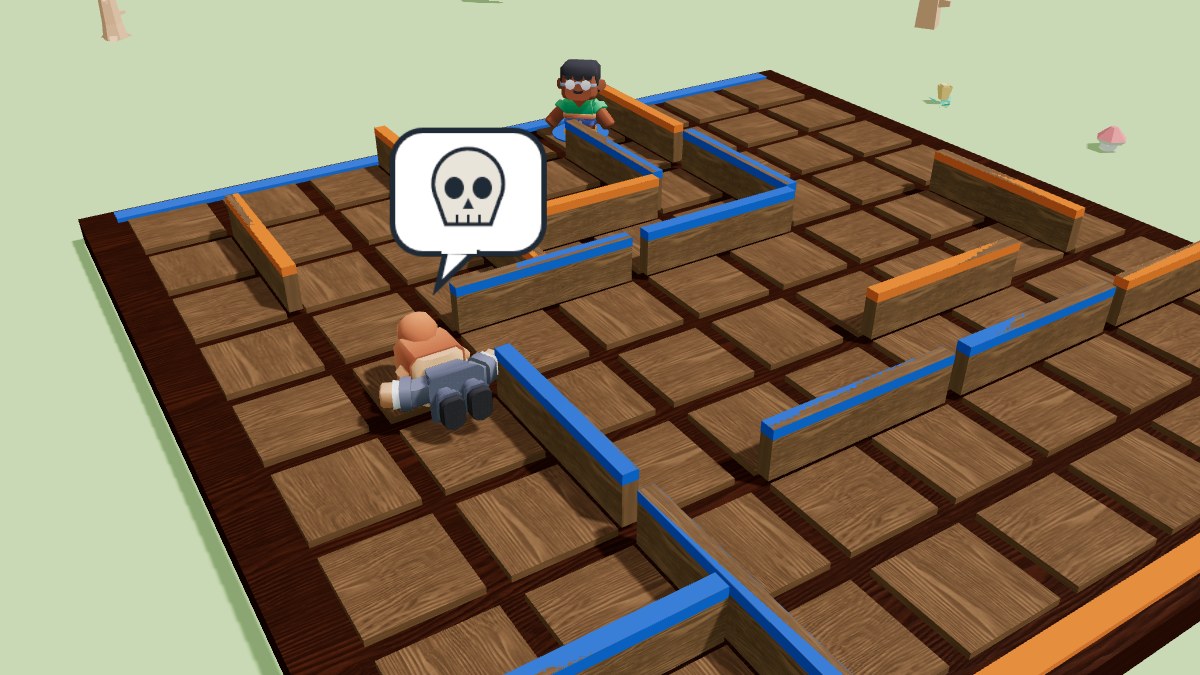
11월 7일 예파 님 승리 판의 마지막 국면을 3D로 옮긴 장면. 파란 띠 벽이 예파 님의 벽입니다.
11월 8일 새벽의 다섯 번째 승리는 이 판과 처음 23수가 똑같았습니다. 수를 섞도록 고쳐 놓았지만, 그 국면들에서는 AI가 보기에 좋은 수가 사실상 하나뿐이라 섞을 후보가 없었습니다.
이긴 수순을 기억해 두었다가 그대로 다시 두는 것까지, 엔진을 상대할 때는 본 적이 없는 방식이었습니다.
정말 사람이었을까
사람이 이기면 혹시 다른 AI를 옆에 띄워 놓고 수를 옮겨 둔 것은 아닌지부터 확인합니다. 사람이 둔 자리마다 sugi와 Sigma라면 무엇을 뒀을지 계산해 일치율을 보고,
수마다 걸린 시간이 얼마나 들쭉날쭉한지도 봅니다. 예파 님 판의 sugi 일치율은 70% 안팎으로, 보통 사람(64%)과 비슷하고 sugi 자신(90%)과는 거리가 멀었습니다.
생각 시간도 1초가 안 걸린 수부터 57초가 넘는 장고까지 제각각이었습니다. 엔진을 옮겨 둔 것이 아니라 직접 찾아낸 수였습니다.
도전을 마치며
11월 8일까지 도전 대국은 72판, AI 64승 사람 8승으로 끝났습니다. 사람 8승 가운데 5승이 예파 님입니다.
사람이 이긴 판들은 학습 재료가 됐습니다. 다만 사람의 수를 따라 배우게 한 것은 아니고, 이긴 판의 중간 국면 약 200개에서 AI끼리 다시 두게 해서 그 결과로 배웠습니다.
그렇게 학습한 모델은 그 국면들에서 AI 쪽이 이기는 비율이 27.6%에서 38.4%로 올랐지만, 대신 sugi나 Sigma 상대 성적이 흔들려서 아직 V3를 바꾸지는 못했습니다.
20수째 가장자리로 들어간 그 판의 국면들은, 지금까지 어떤 모델도 한 번을 이기지 못했습니다.
도전 모드는 11월 9일에 닫았고, 지금 이 사이트는 누구나 바로 둘 수 있는 일반 대국입니다. 일반 대국도 초반에는 비슷하게 좋은 수를 섞어서 둡니다.
AI가 어디서 확신하며 틀리는지, 예파 님 덕분에 처음으로 제대로 봤습니다. 다음 글은 이 판들을 넘는 모델이 나오면 쓰겠습니다.